Come “ragiona” un modello linguistico: token, attenzione e probabilità
Dietro ogni risposta di un LLM c'è un meccanismo sorprendentemente semplice da descrivere: prevedere il pezzo di testo successivo. Capirlo aiuta a usarlo meglio.
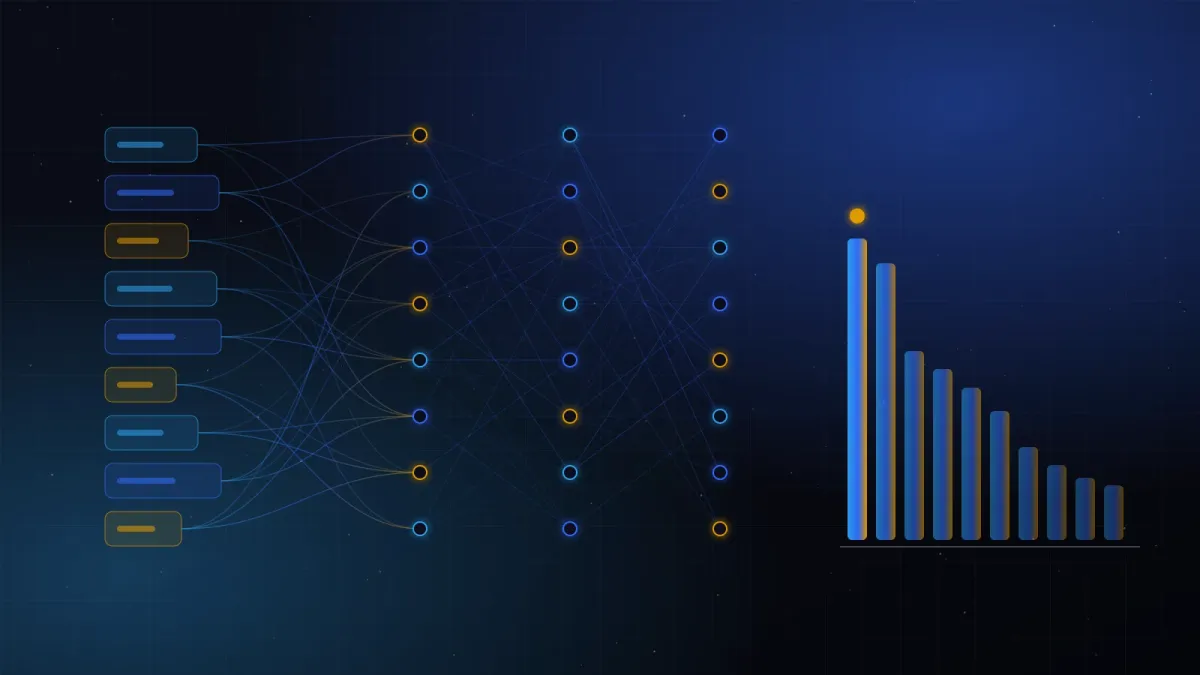
Quando scriviamo una domanda a un assistente come ChatGPT, Claude o Gemini, la risposta arriva fluida, ben argomentata, spesso convincente. È naturale pensare che dall'altra parte ci sia qualcosa che “capisce”. In realtà il cuore di un Large Language Model (LLM) svolge un compito molto più circoscritto: stimare quale pezzo di testo è più probabile che venga dopo. Capire questo meccanismo è il primo passo per usarlo bene e per non farsi ingannare.
Tutto parte dai token
Un modello non legge parole, ma token: frammenti di testo che possono essere una parola intera, una sillaba o un segno di punteggiatura. “Ingegneria” potrebbe diventare due o tre token, “AI” uno solo. Ogni token viene trasformato in un vettore numerico, una lunga lista di numeri che ne rappresenta le sfumature di significato. Parole con usi simili finiscono in zone vicine di questo spazio matematico.
È anche il motivo per cui si parla di “finestra di contesto”: il modello può considerare un numero massimo di token alla volta. Tutto ciò che sta fuori dalla finestra, semplicemente, per lui non esiste.
Il meccanismo dell'attenzione
La svolta che ha reso possibili gli LLM moderni è l'architettura Transformer, presentata nel 2017. Il suo ingrediente chiave è l'attenzione: per ogni token, il modello calcola quanto peso dare a tutti gli altri token del contesto. Nella frase “Il server non risponde perché il disco è pieno”, l'attenzione permette di collegare “risponde” a “server” e “pieno” a “disco”, anche se le parole sono distanti.
Questo calcolo viene ripetuto attraverso decine di livelli sovrapposti. I primi catturano relazioni grammaticali, quelli più profondi associazioni più astratte: tono, argomento, struttura logica del discorso.
Una scommessa alla volta
Alla fine della catena, il modello produce una distribuzione di probabilità su tutto il suo vocabolario: il token “database” al 31%, “server” al 18%, “sistema” al 9% e così via. Ne sceglie uno, lo aggiunge al testo e ricomincia da capo. Una risposta di trecento parole è il risultato di centinaia di queste piccole scommesse in sequenza.
Il parametro chiamato temperatura regola quanto il modello sia conservativo: a valori bassi sceglie quasi sempre l'opzione più probabile, a valori alti si concede più varietà, e più rischi.
Cosa significa per chi lo usa
Da qui discendono tre conseguenze pratiche:
- Le allucinazioni non sono un bug occasionale: il modello produce testo plausibile, non necessariamente vero. Una citazione inventata ha la stessa “forma” di una reale.
- Il contesto è tutto: più informazioni pertinenti fornisci nella richiesta, più le probabilità si spostano verso la risposta giusta.
- La verifica resta umana: numeri, norme, comandi da eseguire in produzione vanno sempre controllati alla fonte.
Un LLM non è un oracolo né un semplice completamento automatico: è uno strumento statistico estremamente potente. Trattarlo come tale è il modo migliore per sfruttarne davvero il valore.